
目次
本記事のポイント
- Copilotは、Bing検索の公開情報とWork IQが意味理解・構造化した社内データを複合的に参照し、回答を生成します。
- 社内データの利用時は、既存のアクセス権限に準拠し、Microsoft 365のデータガバナンスとセキュリティ管理が求められます。
- 適切なプロンプト作成と情報のファクトチェックは、Copilotを効果的に利用するために重要です。
- 組織全体でのガバナンス体制の確立は、Copilotの安全かつ効果的な活用に役立ちます。
1. Copilot Web検索機能の全体像
1.1 Copilotの情報収集能力の基本
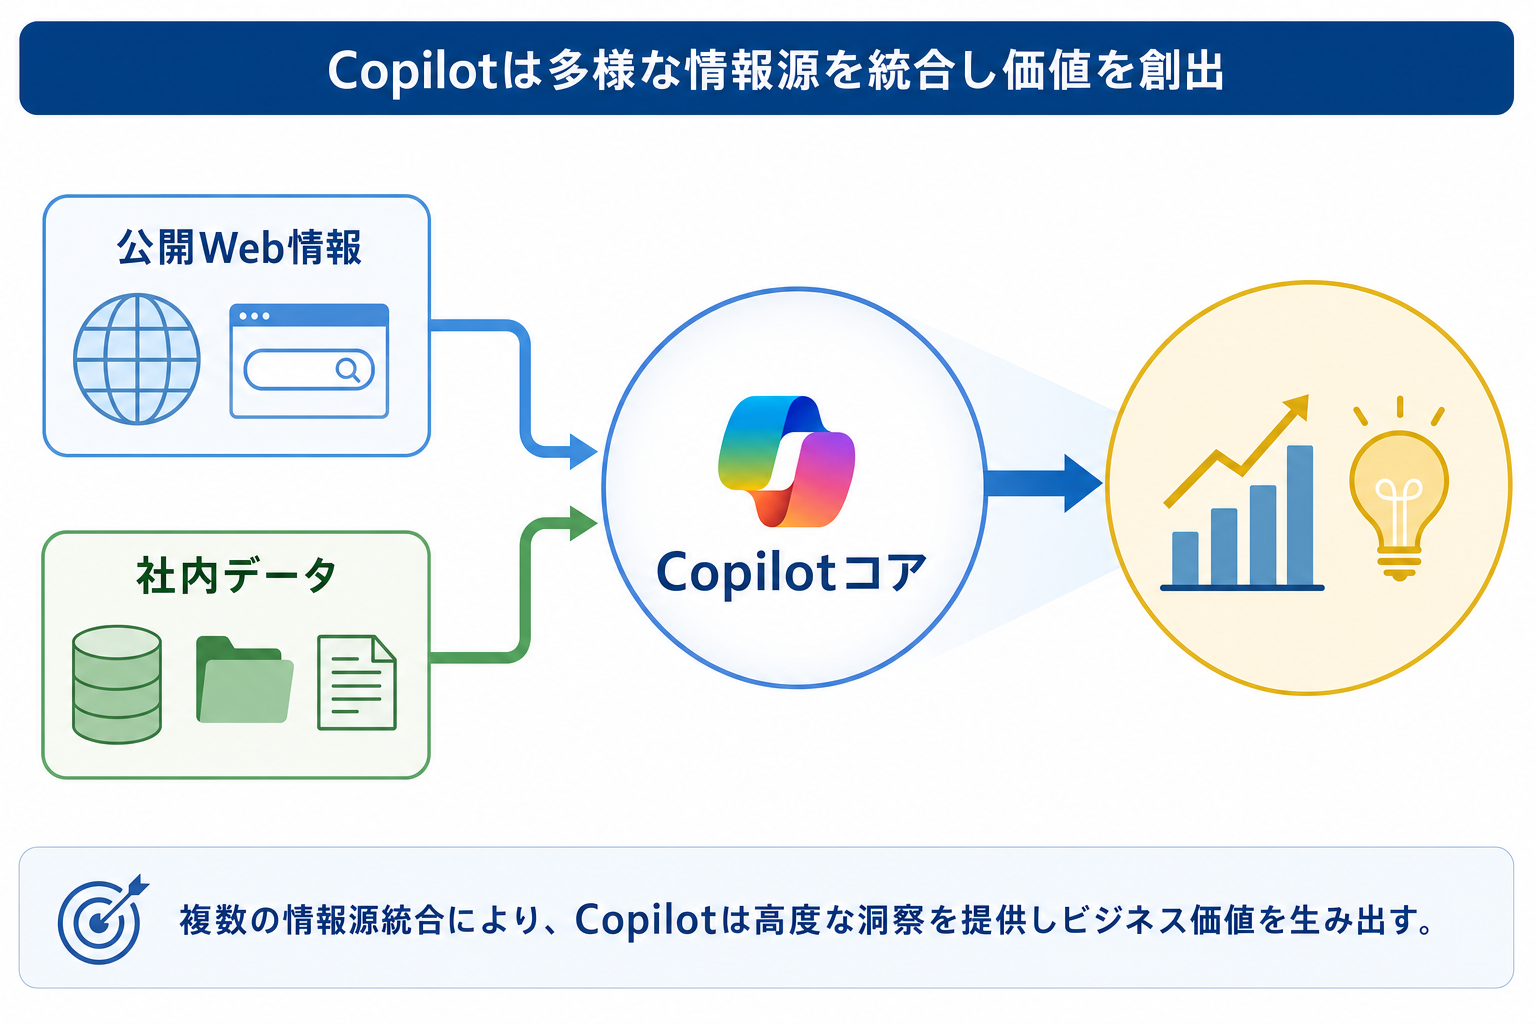
Copilotは、大規模言語モデル(LLM)の学習済みデータのみに依存するわけではありません。情報収集能力の基本として、公開Web情報と組織内の非公開データを柔軟に組み合わせます。一般的なAIモデルは学習時点までの情報しか持たないため、最新の出来事や企業固有の具体的な質問には対応できませんが、CopilotはRAG(Retrieval-Augmented Generation:検索拡張生成)という仕組みにより、外部情報源から必要な情報をリアルタイムで取得し、LLMの知識と組み合わせて回答を生成します。
Copilotは、主に二つの種類の情報にアクセスします。一つはBing検索を通じて得られる公開Web情報、もう一つはMicrosoft Graphを介してアクセスするMicrosoft 365環境内の社内データです。質問の種類によって参照される情報源が異なり、回答の精度、鮮度、機密性が変わるため、ユーザーはプロンプトの意図と情報源の特性を理解する必要があります。
1.2 なぜ複数の情報源を参照するのか
CopilotがWeb情報と社内データの両方を参照するのは、それぞれが異なる情報価値を提供するからです。公開Web情報は、世界の最新トレンドや一般的な知識、広範なトピックに関する網羅性を提供します。「今日の経済ニュースのトップ3」といった時間依存性の高い質問や、特定分野の最新の研究動向など、LLMの学習データには含まれない新鮮な情報を取得できます。
一方、社内データは、組織固有の情報、機密情報、業務プロセスに関する具体的な知識を提供します。例えば、一般的なAIモデルでは、「自社製品の最新機能に関する問い合わせ対応フロー」や「先月の売上報告書の内容」といった、個社固有の質問には答えられません。Web情報と社内データの両方を参照することで、Copilotは最新の市場トレンド(Web)と自社売上データ(社内)を結合して分析するなど、片方だけでは得られない、より深く実用的な洞察を提供します。ユーザーが求める回答の質は情報源の組み合わせで決まるため、回答の期待値を適切に設定し、プロンプトで情報源を意識する姿勢がCopilotの活用には求められます。
1.3 Web検索と企業内データの融合による価値
公開Web情報と企業内データの融合は、単なる情報収集を超え、企業に新たな価値をもたらします。この融合により、パーソナライズされた実践的なインサイトや業務支援が可能になります。
たとえば、営業担当者は顧客情報(社内CRM)と競合他社の最新動向(Web検索)を組み合わせ、個別の商談資料作成のヒントを得たり、戦略的なアプローチを検討したりできます。また、一般的な市場トレンド情報(Web)と自社の営業実績データ(社内)を統合的に分析することで、次なるビジネス戦略立案の精度向上に貢献します。従業員がWebで調べた一般的なFAQと、自社固有の福利厚生規程を組み合わせた回答をCopilotから得ることで、人事関連の問い合わせ対応効率化も期待できます。
この融合がどのような業務改善や意思決定支援に繋がるかを具体的に理解することは、Copilotへの投資対効果を判断する際に必要です。Copilotが提供する価値は、単純な情報検索ではなく、異なる情報源を統合した「洞察」として活用できるため、自社での具体的な活用シーンを検討するきっかけとなります。
2. 公開Web情報源としてのBing検索の役割
2.1 Bing検索エンジンとの連携メカニズム
Copilotが公開Web情報にアクセスする際の中核を担うのがBing検索エンジンです。Copilotは、ユーザーのプロンプトを受け取ると、その内容を分析して最適な検索クエリを生成し、Bing検索をバックグラウンドで実行します。このプロセスは、Copilot自身がインターネットで検索を行っているかのように機能します。
Bing検索の結果として返された情報の中から、Copilotはプロンプトに関連性の高いスニペットやWebページの内容を抽出します。例えば、「〇〇に関する最新のニュース」というプロンプトに対しては、裏側で「〇〇 最新ニュース」といった検索クエリが実行され、検索結果のタイトル、概要、本文の一部などがLLMに渡されます。抽出された情報は、そのままユーザーに提示されるのではなく、LLMの入力として利用され、Copilotが回答を生成する際の「参照情報」の一つとなります。この連携メカニズムを理解すると、なぜ特定の検索結果が回答に反映されやすいのか、あるいは反映されにくいのかを推測できるようになり、プロンプトの調整に役立ちます。Copilotが検索エンジンそのものではなく、これを「道具」として利用していることを理解すると、プロンプトが検索クエリにどう影響するかを意識でき、より効果的な活用につながります。
2.2 最新情報と網羅性を確保する仕組み
CopilotがBing検索と連携する最大の利点は、情報の「最新性」と「網羅性」を確保できる点にあります。LLMの学習データは定期的に更新されますが、常に最新の出来事を反映しているわけではありません。Bing検索のリアルタイムなWebインデックス機能を利用することで、Copilotは学習データには含まれない、ごく最近発生したニュースやトレンド、市場の動向といった鮮度の高い情報を回答に組み込むことが可能になります。
また、Webの広範な情報源にアクセスできることで、Copilotは特定の専門領域やニッチな情報、あるいは一般的な知識を網羅的に提供できます。「今日の経済ニュースのトップ3」といった時間依存性の高い質問に対し、CopilotがBingを通じて最新情報を取得する様子は、この機能の典型的な例です。ただし、この仕組みは、情報が「検索エンジンに存在する」という前提に基づいています。つまり、Bingのインデックス範囲外の情報や、特定のデータベースに格納された非公開情報にはアクセスできないという限界も併せ持っています。最新性が求められる業務(市場調査、ニュース速報など)でCopilotを活用する際、この機能のメリットを享受しつつ、Bingのインデックス範囲外の情報や非公開情報にはアクセスできない限界を理解しておく必要があります。
2.3 検索結果の信頼性と引用元の提示
CopilotがWebから得た情報に基づく回答を生成する際、その信頼性については常に留意が必要です。Web上には誤報や意見、古い情報などが混在しているため、Copilotの回答もこれらの影響を受ける可能性があります。このため、Copilotは回答の透明性を高めるため、可能な限り引用元を提示します。引用元の提示は、ユーザーが情報の信頼性を確認し、ファクトチェックを行うための判断材料となります。
提示された引用元をユーザー自身が確認する具体的な方法としては、リンクをクリックして元のWebページにアクセスし、内容を照合することが挙げられます。特に、重要な意思決定や公開資料の作成においてCopilotを利用する際は、必ず引用元を確認し、情報源の信頼性や情報の鮮度を評価するプロセスを業務フローに組み込む必要があります。引用元が複数ある場合、Copilotがどの情報を優先して採用したかはLLMの判断に委ねられるため、ユーザー側での多角的な検証がより一層求められます。CopilotのWeb検索による回答はあくまで参照情報であり、最終的な情報の信頼性はユーザー自身が引用元を確認し評価することで担保されます。これは、責任ある情報活用において不可欠なプロセスです。
CopilotのWeb検索結果を検証する際のポイント
- ハルシネーションのリスクを認識
- 引用元の確認
- 情報源の信頼性評価
- 複数情報源でのクロスチェック
3. 社内データ連携の仕組みと意義
3.1 Microsoft Graphを通じた社内データアクセス
Copilotが企業内の非公開データにアクセスするための基盤は「Microsoft Graph」です。Microsoft Graphは、Microsoft 365のエコシステム全体にわたるデータ、具体的にはSharePoint Onlineのドキュメント、OneDrive for Businessのファイル、Exchange Onlineのメールやカレンダー、Teamsのチャット記録などを統合し、セキュアなAPIを通じて提供するハブとして機能します。
Copilotは、このMicrosoft GraphのAPIを通じて社内データにアクセスします。この際、既存のアクセス権限が自動的に適用されます。つまり、ユーザーがMicrosoft 365環境でアクセス権限を持たないデータには、Copilotもアクセスできません。この仕組みにより、Copilotはユーザーごとにパーソナライズされた情報を提供しつつ、企業の情報セキュリティポリシーを遵守します。Copilot導入時は、既存のMicrosoft 365環境におけるデータ管理やセキュリティ設定がCopilotの挙動に直接影響することを理解しておく必要があります。ユーザーがOneDriveに保存している特定のドキュメントをCopilotが参照する際、Microsoft Graphが既存のアクセス権限に基づいて機能していることを認識することが、Copilotを安全に利用する上で欠かせません。
3.2 活用される具体的な社内情報源
CopilotはMicrosoft Graphを通じて、Microsoft 365環境内の多様な社内情報源を活用します。これには構造化データと非構造化データの両方が含まれ、企業内の幅広い業務活動の情報資産をカバーします。
具体的には、Copilotは以下のデータにアクセスできます。
- SharePoint Online: チームサイトのドキュメント、プロジェクト計画書、マニュアル、サイトページ情報など。
- OneDrive for Business: ユーザー個人のファイル、個人メモ、ドラフトドキュメントなど。
- Exchange Online: ユーザーのメール(送受信履歴、下書き)、カレンダーの予定、連絡先情報など。
- Microsoft Teams: チャット履歴、会議の議事録(Teams会議のトランスクリプト)、共有ファイルなど。
- その他: Project Onlineのプロジェクトデータ、Viva Engageのディスカッション、Microsoft Loopコンポーネントなど、Microsoft 365エコシステム内の様々なデータ。
例えば、「先週の営業会議の議事録はどこか」という質問に対しては、Teamsのチャット履歴やSharePoint上に保存されたファイルが参照される可能性があります。ただし、Microsoft 365と連携されていない外部システムや、オンプレミス環境に存在するデータは、初期状態ではCopilotの活用対象外です。Copilotを導入する際は、どの部門のどのデータが活用対象となるか事前に把握し、情報の整理やガバナンス設計の出発点とする必要があります。
3.3 企業データ活用におけるセキュリティとプライバシー保護
Copilotによる社内データ活用では、情報漏洩やプライバシー侵害のリスク管理が課題となります。MicrosoftはCopilotを「エンタープライズ対応AI」と位置づけ、セキュリティとプライバシー保護のメカニズムを組み込んでいます。
Copilotは、ユーザーの既存のアクセス権限(User Context)を超えてデータにアクセスしません。これは、Copilotが「個人のAIアシスタント」として機能し、ユーザーが見ることのできる情報のみを参照するという設計思想に基づきます。例えば、人事情報へのアクセス権限がないユーザーがCopilotで「社員の給与リスト」を質問しても、情報にはアクセスできません。
さらに、Microsoft 365が提供する高度なセキュリティおよびコンプライアンス機能がCopilotにも適用されます。これには、情報漏洩対策(DLP: Data Loss Prevention)、機密ラベル(Sensitivity Labels)によるデータ分類と保護、監査ログ(Audit Log)による利用状況の追跡などが含まれます。また、企業のデータが大規模言語モデル(LLM)の学習データとして使用されることはありません。これにより、各企業のデータが外部に流出したり、他の企業のCopilot利用に影響を与えたりするリスクを排除します。
企業はCopilotを安全に利用するために、既存のデータガバナンスポリシーを再確認し、強化する必要があります。Copilotのセキュリティは既存のアクセス権限に依存するため、自社のデータガバナンス体制がCopilotの安全な利用に直結します。
Copilot社内データ活用のセキュリティ対策チェックリスト
- アクセス権限の見直し: Microsoft 365内の全データに対し、最小権限の原則に基づいたアクセス権限設定が適切か定期的に監査・見直しを行う。
- 情報ライフサイクル管理: 不要な情報が放置されていないか、適切な期間でアーカイブまたは削除される仕組みを整備する。
- DLPポリシーの適用: 機密情報を含むファイルに対する情報漏洩対策(DLP)ポリシーが正しく設定・運用されているか確認する。
- 機密ラベルの活用: データの機密性に応じたラベル付けと保護設定(暗号化など)を促進し、ユーザーへの周知を徹底する。
- 監査ログの監視: Copilotの利用状況やデータアクセスログを定期的に監視し、不審な挙動がないか確認する体制を構築する。
4. Work IQ:社内情報活用の司令塔
4.1 Work IQの定義と主な機能
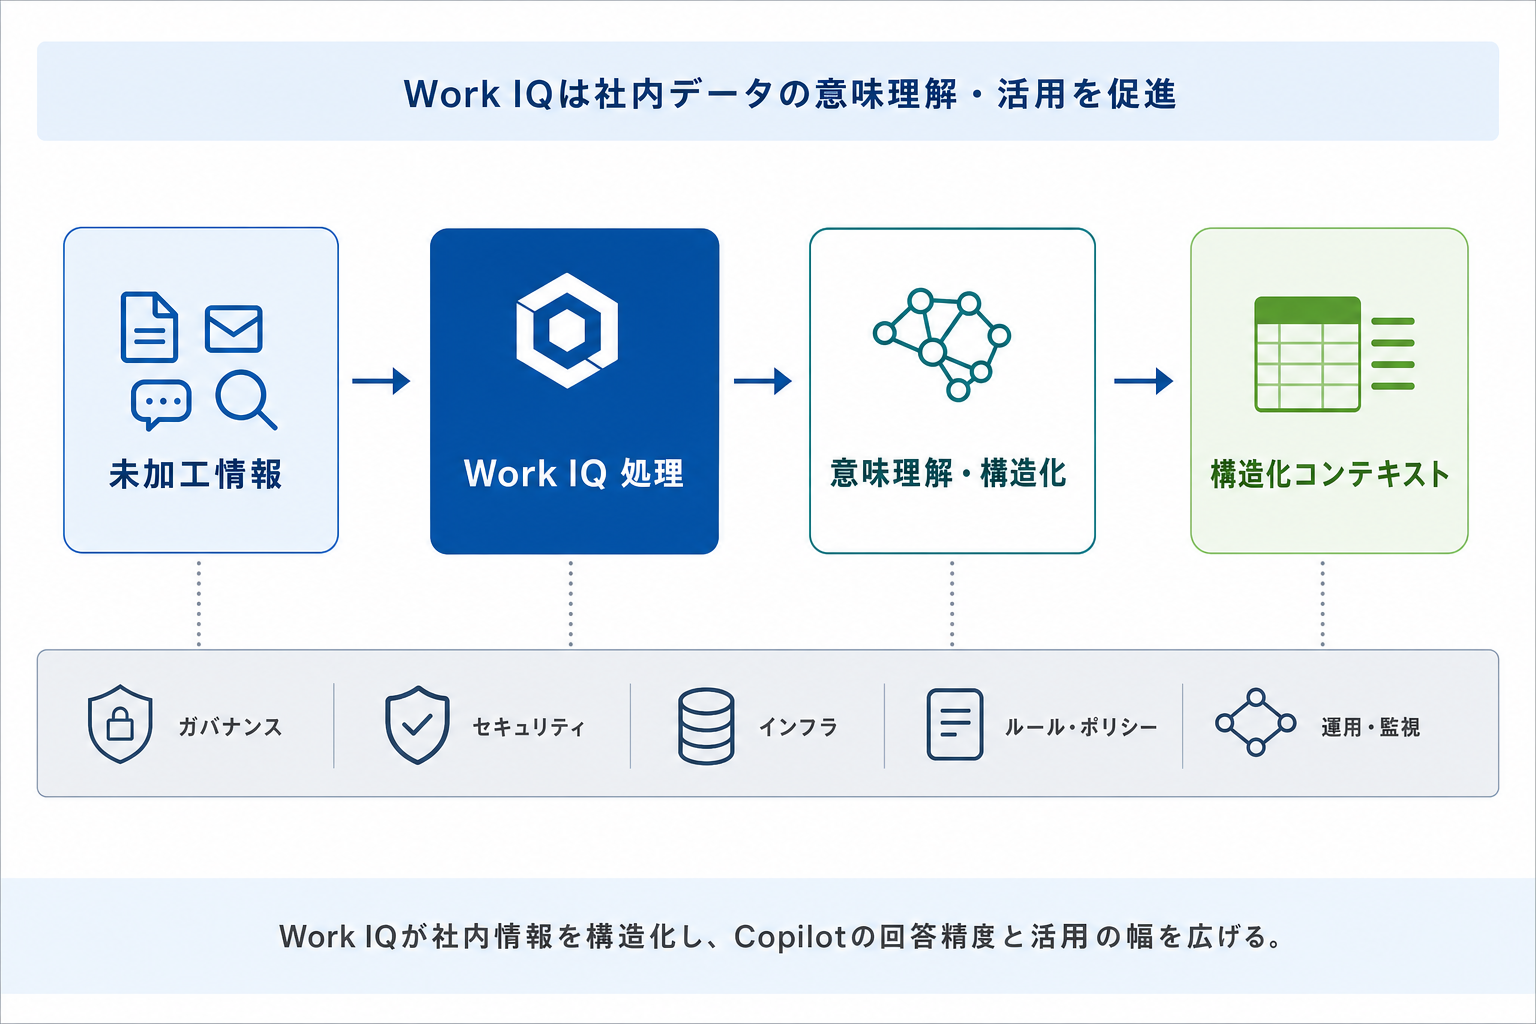
Work IQは、Microsoft Copilotにおいて社内情報活用の司令塔として機能します。Microsoft Graphにより多様な社内データがCopilotにアクセス可能になっても、膨大な非構造化データ(文書、メール、チャットなど)をそのままLLMに与えても、効率的な意味理解や活用は困難です。Work IQは、これらの社内データに高度な処理を施し、LLMが深く意味を理解しやすい形に構造化・整理します。
Work IQの主要な機能は、セマンティックインデックスの構築です。これは単なるキーワード検索ではなく、文書内の単語、フレーズ、文脈、関係性を分析して意味的なインデックスを作成する技術です。これにより、ユーザーのプロンプトが示す意図(セマンティクス)に基づき、関連性の高い情報を迅速に引き出します。Work IQはさらに、ドキュメントから人、場所、プロジェクト名、日付などの「エンティティ」を抽出し、相互に関連付けて情報を組織化します。また、抽出情報の要約や、複数情報源からの関連断片の統合も行います。
Work IQは、単なるデータ収集ではなく社内データの「意味」を理解し、利用可能にする中核技術です。例えば、「先月の取締役会議事録」という質問に対し、キーワードだけでなく会議の目的や関連するプロジェクトに基づいて情報を見つけることが可能になります。
4.2 非構造化データの意味理解と組織化
企業内の情報の大半は、形式が定まっていない非構造化データとして存在します。メールの本文、チャットの会話、ドキュメント内の自由記述テキストなどは、従来のデータベース検索では見つけにくい「意味」や「文脈」を含んでいます。Work IQは、非構造化データから意味を理解し整理するため、自然言語処理(NLP)と機械学習技術を駆使します。
Work IQはテキスト内のキーワードだけでなく、文脈全体を分析し、文書のトピックや内容を把握します。加えて「エンティティリンキング」により、抽出したエンティティ(例:顧客名、製品名、日付)を既存の知識ベースや他の社内データと紐付け、相互に関連付けます。これにより、単一のドキュメントの枠を超え、企業内の情報全体からグラフ構造のように関連性を構築し、情報の断片から全体像を構築します。
例えば、顧客からの問い合わせメール(非構造化データ)から、「顧客名」「製品名」「問い合わせ内容」といった具体的な情報を抽出し、それらを関連する社内資料(製品マニュアル、過去の対応履歴)と紐付けることが可能です。このプロセスは、人間が意図しなかった関連情報の発見につながります。ただし、元データの品質が低いと、意味理解の精度も低下する場合があります。そのため、自社のドキュメントやコミュニケーション履歴の整理状況が、Work IQによる意味理解の精度に影響します。
4.3 Work IQがBingと社内データを統合するプロセス
Work IQは社内データを整理するだけでなく、CopilotがBing検索から得た公開情報と、整理した社内データをLLMに提供するプロセスを担います。ユーザーがプロンプトを入力すると、Copilotはその意図を解釈し、必要な情報源がWeb情報(Bing)、社内データ(Work IQ)、またはその両方かを判断します。
この判断に基づき、CopilotはBing検索を実行して公開情報を収集し、Work IQに社内データの検索を指示します。Work IQはセマンティックインデックスを用いて社内データから関連性の高い文書やエンティティを抽出し、Copilotに情報を返します。CopilotはBing検索結果とWork IQからの社内データを関連付け、これら複数の情報源から得られた情報を、LLMが活用しやすいよう統合された「コンテキスト」として提供します。
例えば、「最新の市場トレンド(Web)と自社製品の販売実績(社内)を比較したレポート案」というプロンプトに対し、Work IQは両方の情報源からデータを集約し、LLMがこれらを統合的に分析・比較できるよう支援します。このプロセスにおいて、どちらの情報源が優先されるかは、固定の優先順位があるわけではなく、プロンプトの文脈や質問の性質によってCopilotが判断します。そのため、完全に自動で最適な優先順位が決定されるわけではなく、プロンプトの設計が、この統合結果に大きく影響することを理解しておく必要があります。
5. Copilotが情報統合と回答生成を行うプロセス
5.1 プロンプト解釈から関連情報収集まで
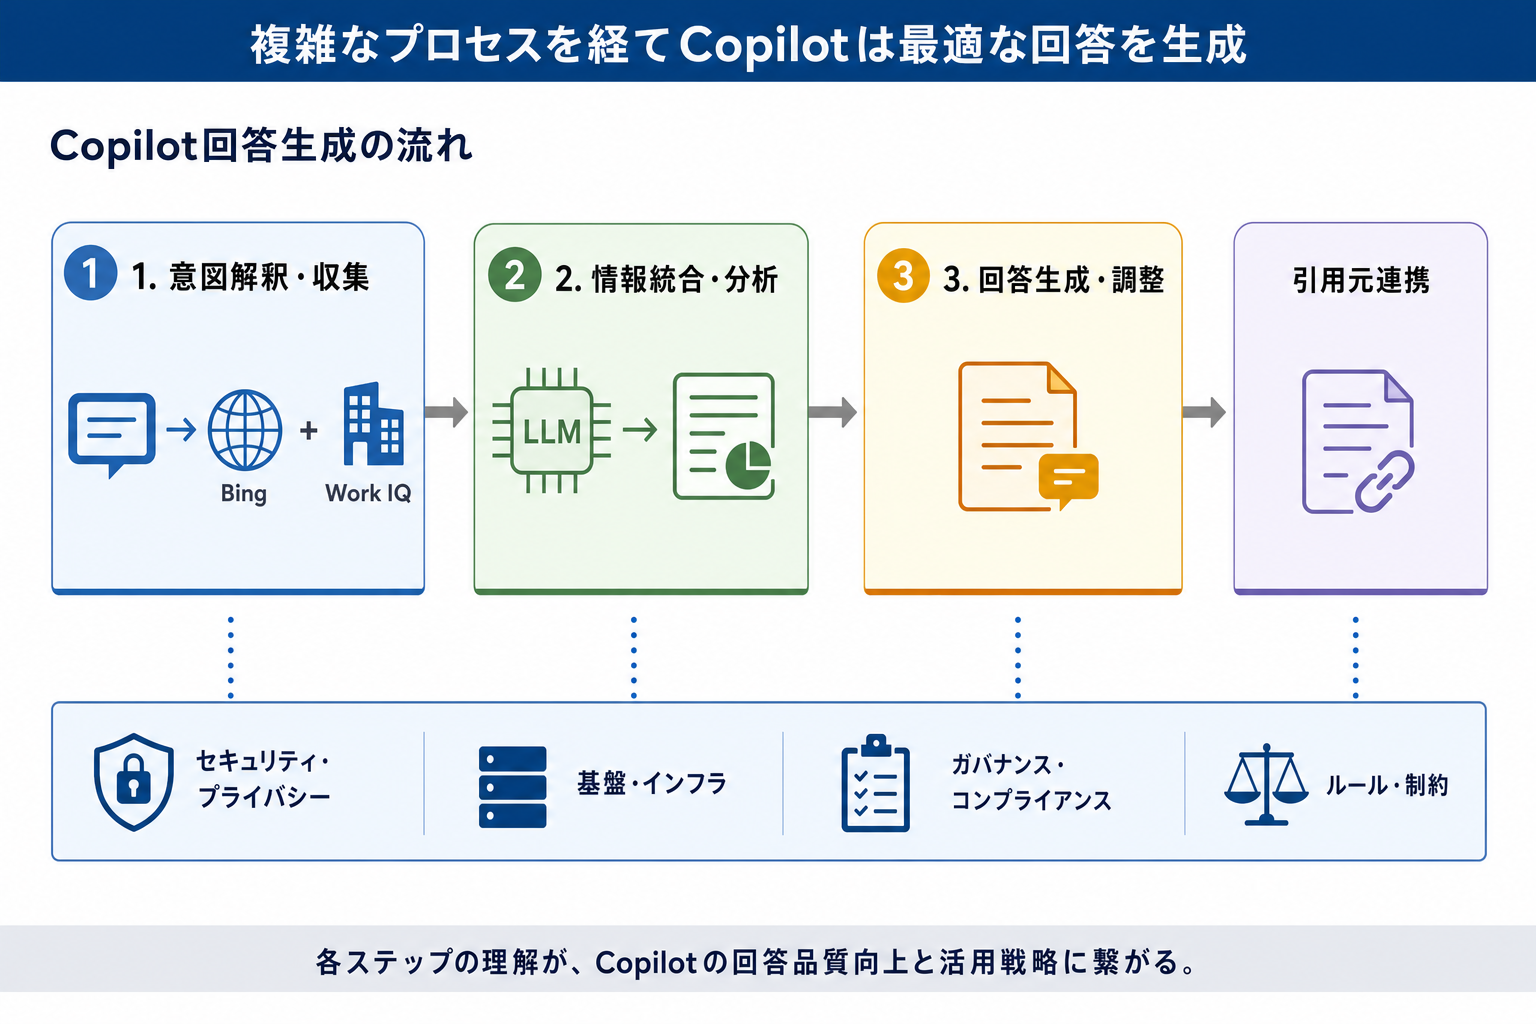
ユーザーがCopilotにプロンプトを入力すると、まずその意図(インテント)を特定するプロセスから始まります。Copilotは、ユーザーが求める情報、実行してほしいタスク、必要な情報源を解析します。この解釈が、その後の情報収集の方向性を決定します。
プロンプトの意図が特定されると、Copilotはそれに基づきWeb検索用クエリや社内データ検索用クエリを自動生成し、それぞれの情報源へアクセスします。Bing検索からは関連性の高いWebページのスニペットや要約が、Work IQからは社内文書、メール、チャット記録などから抽出された関連文書やエンティティが収集されます。
この段階で、Copilotはユーザーのアクセス権限に基づき、参照可能な情報のみを収集します。例えば、プロンプトが「市場トレンドについて教えて」と抽象的であればWeb検索が中心となり、「〇〇プロジェクトの進捗状況を教えて」であればWork IQを通じた社内データ検索が主になります。プロンプトの曖昧さによっては、Copilotがユーザーの意図と異なるクエリを生成する可能性があり、その場合、適切な情報源からの正確な情報収集が妨げられることがあります。
5.2 複数情報源からの関連性判断と分析
CopilotがBing検索とWork IQから関連情報を収集した後、これらを統合し、回答の基盤となる情報構造を構築します。このプロセスでは、収集されたWeb情報と社内データ間の関連性をLLMが評価します。LLMはセマンティックな一致度(意味的な類似性)を基準に、情報がプロンプトの意図にどれだけ合致しているかを判断します。
複数の情報源から得られたデータは、そのまま並べられるわけではありません。LLMは情報源間で矛盾する情報がないかを確認し、矛盾が見つかった場合にはその処理方法を判断します。例えば、どちらか一方を優先するか、または両方の情報を提示してユーザーに判断を委ねるといった選択が行われることがあります。同時に、相互補完的な情報や異なる粒度の情報を統合し、ユーザーの質問に対する包括的な回答を生成するための要約や分析を行います。
例えば、ある製品のWeb上での評判(Web情報)と、社内の顧客からのクレーム履歴(社内データ)を比較し、共通点や相違点を分析するといった処理が行われます。このような分析・統合により、収集された情報がそのまま回答になるのではなく、LLMによる解釈が加えられます。ただし、複雑な判断や高度な解釈が必要な場合、LLMの限界があることも認識しておく必要があります。Copilotは情報を分析・統合する役割を担いますが、その判断精度はLLMの能力と情報品質に依存します。
5.3 ユーザーへの回答生成と出力の調整
収集・分析・統合された情報に基づいて、Copilotは最終的な回答を生成し、ユーザーに提示します。このプロセスは、LLMの自然言語生成(NLG)能力によって行われます。回答生成の際には、ユーザーのプロンプトで指定された形式やトーンが影響します。例えば、「〇〇に関する概要を箇条書きで、参照元を明記して」と指示すれば、その要望通りの形式で回答が生成されます。
回答の形式は、要約、箇条書き、比較表、ドラフト文書など多岐にわたります。Copilotは、プロンプトの意図と指定された出力形式に合わせて、最適な言葉遣いや構成を選択します。情報源がWeb検索からのものである場合、回答には可能な限り引用元へのリンクが明示されます。これにより、ユーザーは回答の根拠を確認し、情報の検証を行うことが可能になります。
ただし、この段階でも「ハルシネーション」、つまりLLMが事実に基づかない情報を生成するリスクが存在します。そのため、Copilotの回答は最終的な正解ではなく、ユーザー自身が内容を確認・検証する責任を負う必要があります。回答生成は単なる情報出力ではなく、ユーザーの指示(プロンプト)によって出力形式や表現を調整できるため、実用的な出力を得るにはプロンプト調整の習熟が求められます。
6. 安全かつ効果的な利用のためのポイント
6.1 精度の高いプロンプト作成のコツ
Copilotから質の高い回答を引き出すには、精度の高いプロンプト作成スキルが求められます。プロンプトはCopilotへの「指示書」であり、その明確さが情報収集の質を左右します。以下の要素を意識することで、Copilotの回答精度が高まります。
まず、「何をしてほしいか」を具体的に指示するタスクの具体化が必要です。次に、Copilotに「広報担当者として」「データアナリストとして」といった「役割」を与えます。これにより、回答のトーンや内容を調整できます。
また、参照する情報を限定することも効果的です。Web情報と社内データのどちらを重視するか、特定のファイル名や期間を指定することで、Copilotが焦点を当てる情報源を絞り込みます。加えて、出力形式を明確に指示してください。「箇条書きで要約」「比較表形式で」「A4一枚に収まるように」など具体的な形式を指定すると、業務で活用しやすいアウトプットが得られます。
最後に、制約条件を加えると、より精緻な回答を求めることができます。「文字数は〇〇以内」「〇〇というキーワードを含める」「〇〇の情報は除外する」といった条件で、回答の方向性をコントロールします。
例えば、「来月の新製品発表会のプレスリリースを作成して」といった漠然としたプロンプトではなく、「広報担当者として、来月開催される新製品発表会のプレスリリース初稿を作成してください。Webで検索できる最新の市場動向を参考にし、社内にある製品資料(ファイル名:新製品A_スペック.pptx)の内容を含めてください。A4一枚に収まるよう簡潔に、箇条書きと段落を組み合わせてください。」といった具体的なプロンプトであれば、Copilotはより的確な回答を生成します。組織内でプロンプト作成のベストプラクティスを共有し、トレーニングを実施することで、Copilotの全社的な活用度を高めることにつながります。
高品質なCopilotプロンプト作成の基本要素
- 明確なタスク指示: 実行してほしいタスクを具体的に記述します(例:「レポートを作成」「アイデアを提案」「要約する」)。
- 役割の付与: Copilotに特定の役割(例:「マーケティング担当者として」「人事部長の視点で」)を与え、回答の視点を定めます。
- 参照情報源の指定: Web検索、社内文書、特定のファイル名、特定の期間など、参照すべき情報を限定します。
- 出力形式の指示: 回答の形式(例:「箇条書きで」「比較表で」「300字以内の要約で」)を具体的に指定します。
- 制約と条件の追加: 含めるべきキーワード、除外すべき情報、トーン(例:「丁寧な言葉遣いで」)など、回答の制約を設けます。
6.2 出力情報のファクトチェックと検証の重要性
Copilotは強力なツールですが、生成する情報の信頼性については、常に人間の検証が必要です。Copilotの回答は、誤情報、不正確な解釈、あるいは「ハルシネーション(もっともらしい虚偽情報)」を含む可能性があります。特に、重要な意思決定や外部公開資料にCopilotの出力を使用する際には、必ずファクトチェックを行うプロセスを業務フローに組み込んでください。
ファクトチェックの具体的な方法として、まずCopilotが提示する引用元リンクへアクセスし、元のコンテンツと生成された回答を照合します。元の情報源が信頼できるか、情報が最新かどうかも確認しましょう。さらに、Copilotの回答だけでなく、複数の情報源(公式ウェブサイト、公的機関のデータ、信頼できるニュースメディアなど)とクロスチェックすることで、情報の正確性を多角的に検証できます。
例えば、「今日の株価」のようなリアルタイム情報や「特定企業の財務データ」のような正確性が強く求められる情報については、必ず公式情報源と照合します。企業として、Copilotの利用ガイドラインにファクトチェックの義務と責任範囲を明確に規定し、従業員への周知と教育を行うことで、情報リスクを最小限に抑えることが可能です。Copilotの回答は最終的な「正解」ではなく、人間の判断を補完するものであり、情報の最終責任は人間にあることを認識してください。
6.3 企業におけるCopilot利用のガバナンスと運用体制
企業でCopilotを安全かつ効果的に運用するには、技術的な導入だけでなく、組織的なガバナンスと運用体制の設計が求められます。これはデータ管理、セキュリティ、従業員教育を含む包括的な戦略として位置づける必要があります。
まず、利用ポリシーの策定が必要です。Copilotの利用目的、扱ってはいけない情報、最終的な責任の所在を明確に定めます。次に、Microsoft Graphによるアクセス権限の適用を前提として、アクセス権限管理の継続的な見直しを実施します。不要な情報へのアクセスを防ぐため、権限が適切に設定されているか定期的に監査し、最適化してください。
また、情報ライフサイクル管理とデータ分類の徹底も求められます。社内データの品質はWork IQの性能に直結するため、古いファイルや不要な情報の整理、機密性に応じたデータ分類(機密ラベルの活用など)を徹底しましょう。そして、従業員への継続的な教育と、プロンプト作成のベストプラクティス共有は、Copilotの効果を最大化し、リスクを低減するために必要です。最後に、利用状況の監視と監査ログの活用を通じて、不正利用や情報漏洩の兆候を早期に検知できる体制を構築してください。
例えば、新規事業提案書作成でのCopilot利用において、参照可能な社内資料の範囲を明確にし、生成された提案書の最終レビューを必ず部門長が行うといったルールを定めることで、ガバナンスを効かせた運用が可能です。Copilotの導入は、データ管理者やIT部門が主導し、組織全体の情報資産管理と運用体制に関わるプロジェクトであるため、その見直しと強化を検討しましょう。
7. Copilot Web検索機能の将来展望と導入検討
7.1 機能拡張の可能性とビジネスへの影響
CopilotのWeb検索機能を含むCopilot全体は、今後も継続的に進化が見込まれます。この進化は、企業がCopilotをビジネスに活用する方法に大きな影響を与えるでしょう。
将来的な機能拡張として、より複雑なプロンプトへの対応と多段階推論が挙げられます。これにより、ユーザーは高度で抽象的な指示をCopilotに与え、Copilotは複数のステップを踏んで論理的に回答を導き出す能力を高めることが期待されます。また、Microsoft 365以外の外部SaaSとの連携強化も期待されます。企業の業務データがより広範囲にCopilotの参照対象となり、包括的なインサイトや業務支援が可能になるでしょう。
さらに、個人の利用履歴やプロファイルを考慮したパーソナライズされた情報提供も進化する見込みです。ユーザーの過去の行動や興味に基づき、より関連性の高い情報や提案を能動的に行うようになることも考えられます。将来的には、テキスト情報だけでなく、画像や動画などのマルチモーダルな情報源の活用も進化し、より多角的な情報収集と分析が可能になるでしょう。企業はこれらの機能拡張を見据え、現在の導入計画が将来の進化に対応できる柔軟性を持つか、あるいはどの時点での導入が自社にとって最適かを見極める必要があります。
7.2 企業が導入時に考慮すべき課題と準備
Copilotの導入は、ソフトウェアのインストールだけで完結しません。そのポテンシャルを引き出し、同時にリスクを管理するには、多岐にわたる課題を考慮し、入念な事前準備が必要です。
まず、社内データ(文書、ファイル、コミュニケーション履歴など)の品質と整理状況は、Work IQが情報を理解し活用できるかを左右します。不要な情報が混在したり、情報の更新が滞ったりしていると、Copilotの回答精度は低下します。例えば、PoCを開始する前に、パイロット部門のSharePointサイト内で使われていないファイルや権限が不明確なファイルを整理・クリーンアップする作業は、Copilotの導入効果を高めます。
次に、既存のアクセス権限管理の見直しと最適化が必須です。Copilotはユーザーの権限に基づき情報にアクセスするため、誤った権限設定は情報漏洩リスクに直結します。また、情報ガバナンスとセキュリティポリシーの再確認・強化も行います。Copilotの利用範囲、機密情報の取り扱い、ハルシネーションへの対応方針などを明確にしたガイドラインを策定し、従業員への周知徹底が必要です。
さらに、従業員への利用ガイドラインとトレーニングプログラムの準備は、Copilotの導入効果を最大化し、適切な利用を促すために必要です。導入効果を測定するため、効果測定指標(KPI)の設定も行いましょう。PoCの段階で、「生産性向上」「情報検索時間の短縮」など、具体的な成功基準を明確に定めることで、次のステップに進む判断が可能になります。これらの準備が不足すると、Copilot導入後の効果が限定的になったり、予期せぬリスクが発生したりする可能性があります。
7.3 Copilotを最大限に活用するための戦略的アプローチ
CopilotのWeb検索機能を含むCopilot全体を企業として最大限に活用するには、「一度導入すれば終わり」ではなく、継続的な学習と改善、そして戦略的なアプローチが求められます。
まず、スモールスタート(PoCやパイロット導入)と段階的拡大から始めます。最初から全社展開を目指すのではなく、特定の部門や業務(例:マーケティング部門での市場調査レポート作成、開発部門での仕様書作成支援)に限定して導入し、その効果を測定しながら段階的に活用範囲を広げます。これにより、導入初期のリスクを抑えつつ、Copilotの運用ノウハウを蓄積できます。
次に、継続的な効果測定とフィードバックループの構築が必要です。Copilotが業務効率化や意思決定支援にどれだけ貢献しているかを定量的に評価し、その結果をプロンプト作成ガイドラインの改善やデータガバナンスポリシーの見直しにフィードバックする体制を確立します。
さらに、AIリテラシー教育とプロンプトエンジニアリングスキルの育成への投資も必要です。従業員がCopilotの能力と限界を正しく理解し、効果的なプロンプトを作成できるようになることで、ツールの価値を最大化できます。成功事例の共有や組織内でのベストプラクティス確立も、AI活用文化を醸成する上で役立ちます。
最終的には、Copilotの活用を具体的なビジネス目標と紐付ける戦略的な視点を持つことが重要です。単なるツール導入としてではなく、組織の生産性向上、イノベーション促進、顧客体験改善といった上位目標達成のための手段として位置づけ、長期的な視点で活用戦略を構築します。